C++
シリアライザを作る
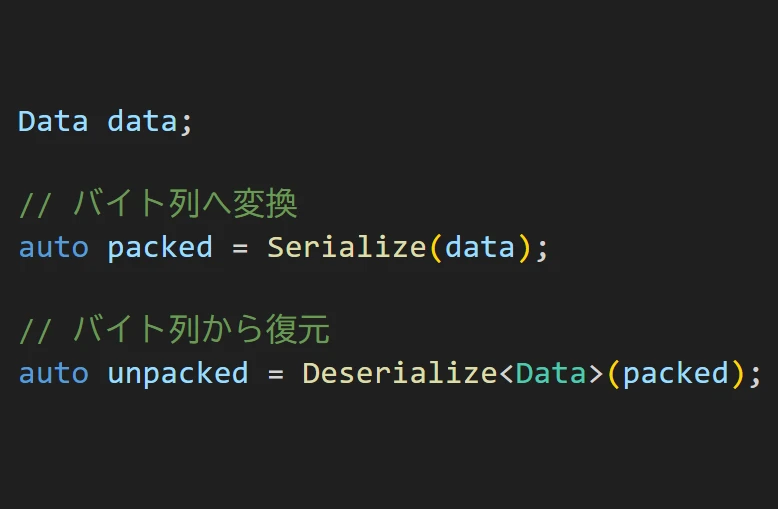
シリアライザを作った際のメモです。
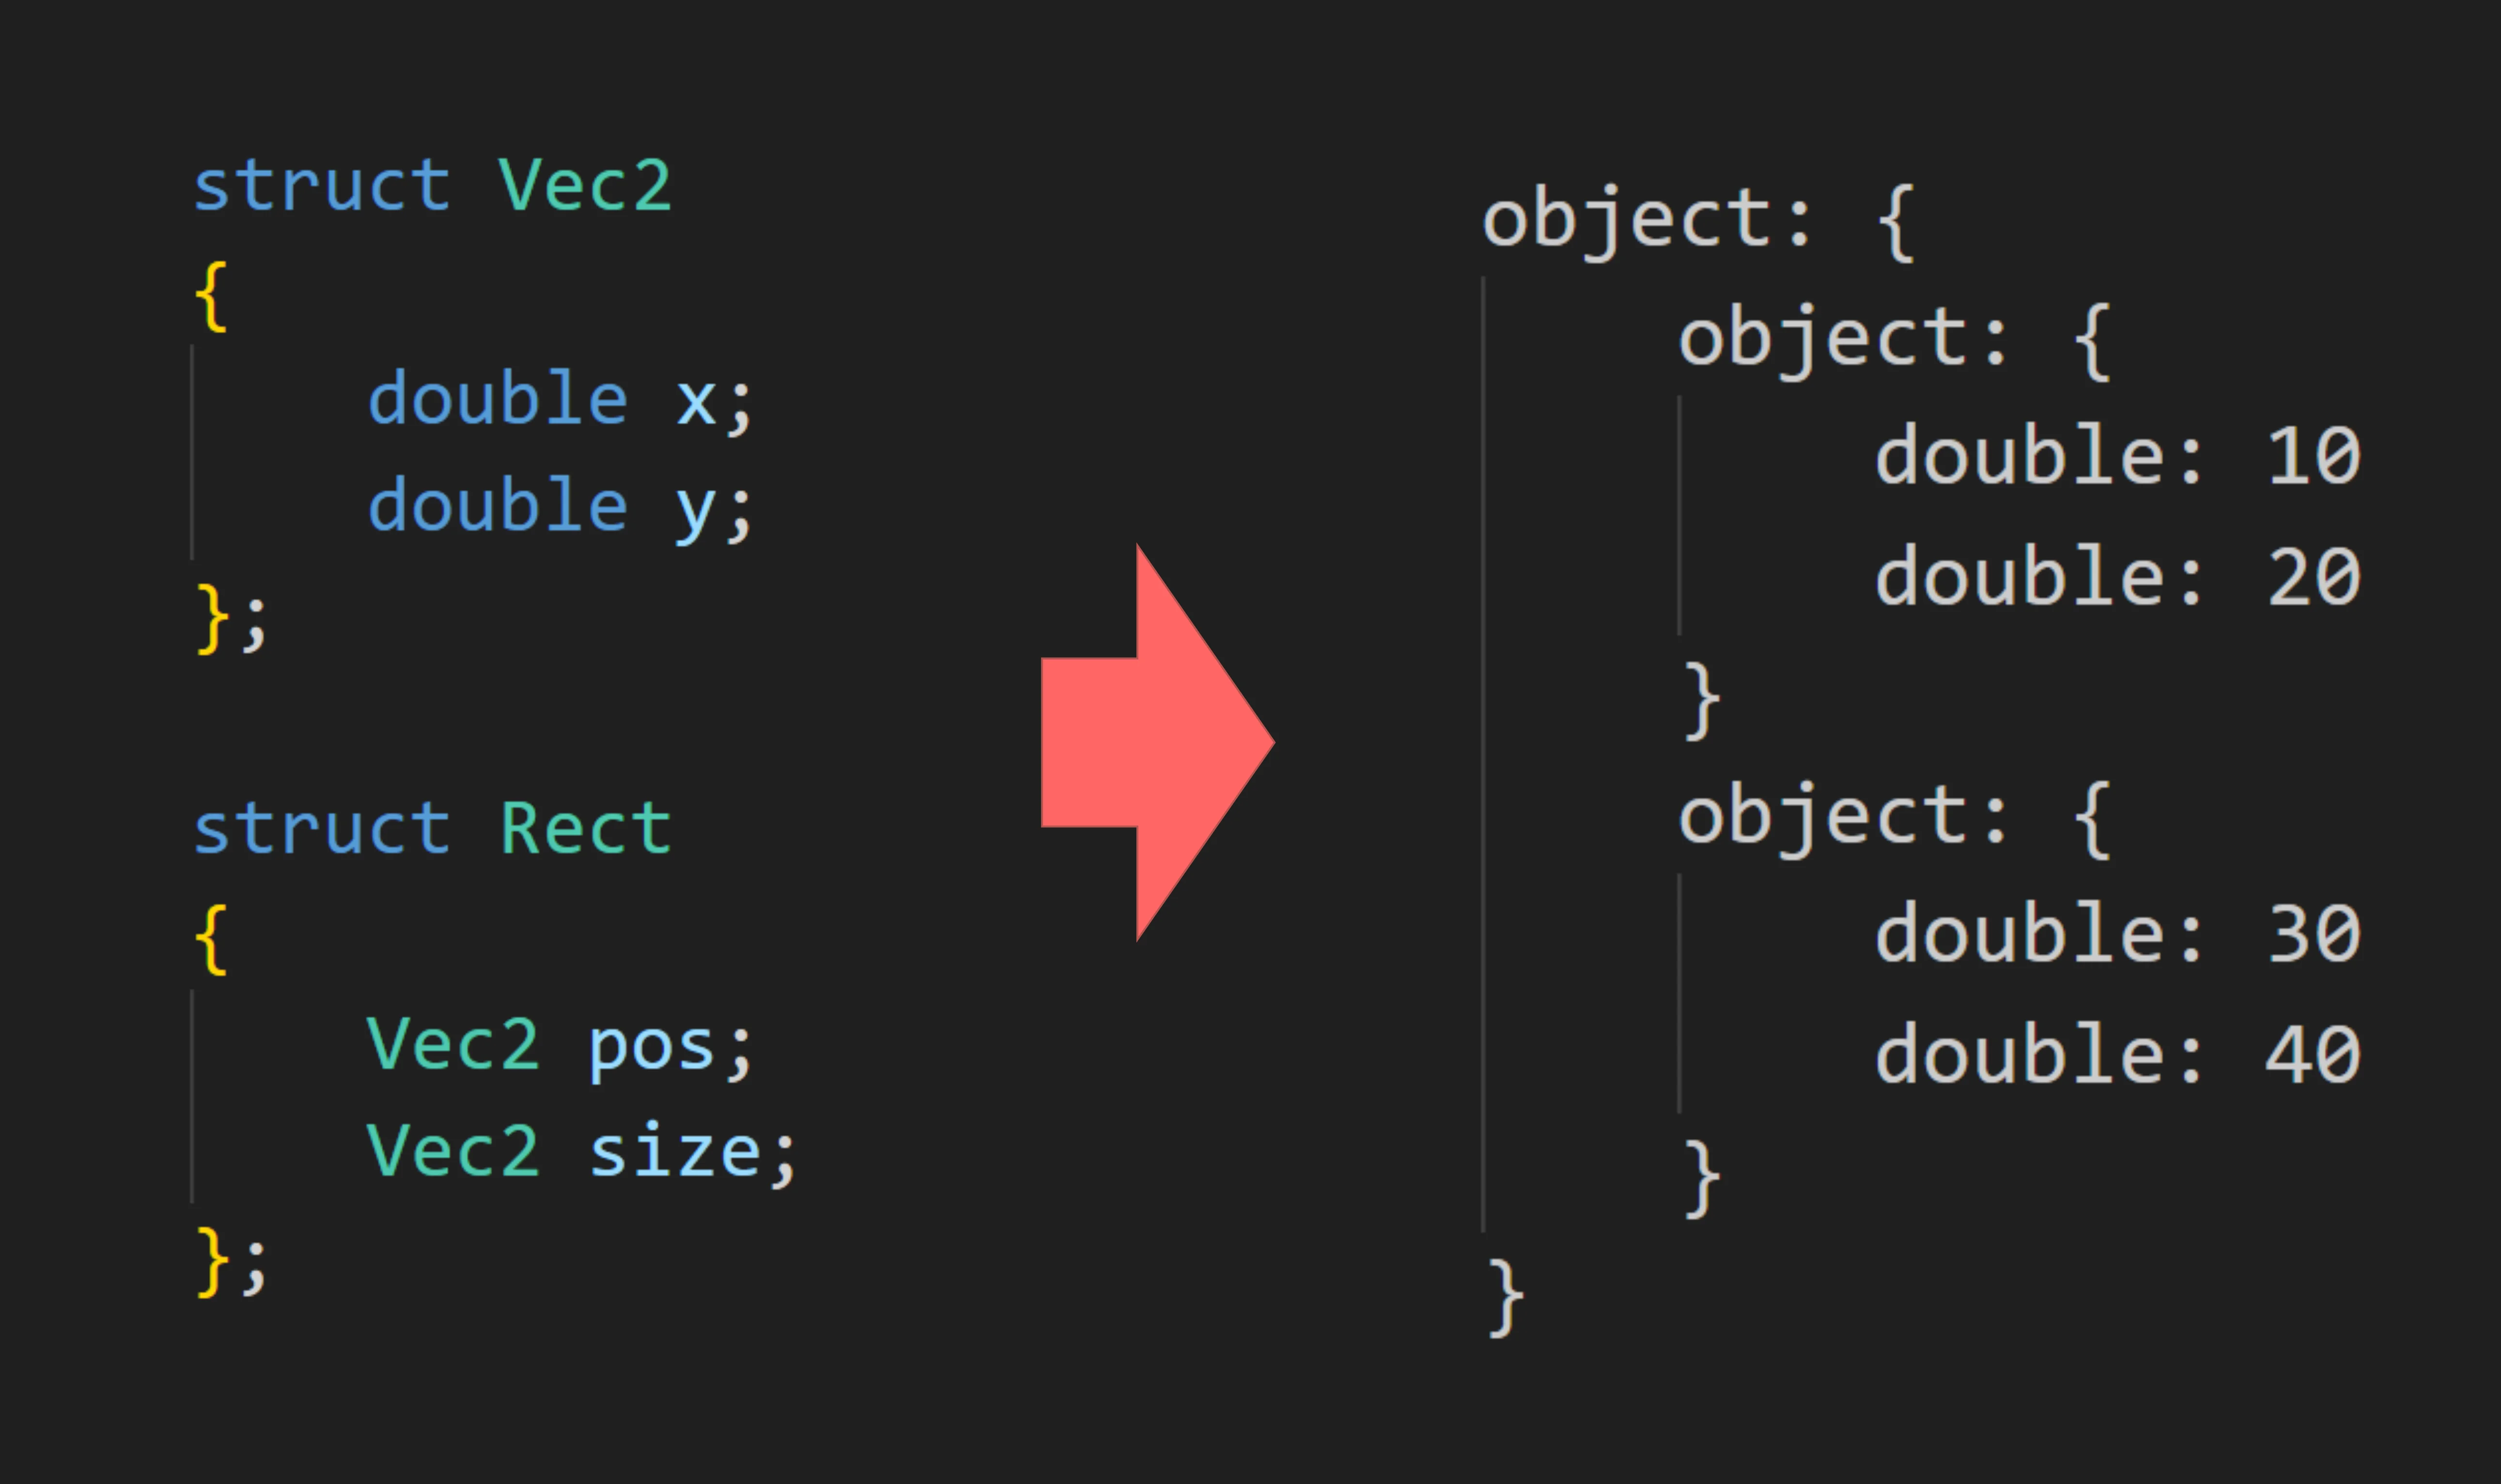
シリアライザとは、構造体等のオブジェクトをバイト列に変換する機能です。通信関係のライブラリを作る際に必要になったため自作しました。
実装する際には、環境の違いによって変換後のバイト列の順序やサイズが異なる可能性があるため、なかなか大変です。オブジェクトをバイト列に変換した際、CPU のエンディアンや ABI、コンパイラの仕様によって、データの配置やパディングの有無が変わることがあります。
実装時に気をつける環境の違いによる影響:
- エンディアンが異なる点
- 浮動小数点型のサイズが異なる点
- 構造体のパディングサイズが異なる点
実装したこと:
- メンバ変数の列挙(パディングによるサイズの違いの対策)
- シリアライズ後のサイズをコンパイル時に算出する
- エンディアン変換
- 浮動小数点型のサイズが異なる問題の対策
エンディアン
オブジェクトをメモリに配置する際のバイト列の並び順のことです。主にビッグエンディアンとリトルエンディアンの 2 種類があります。
ビッグエンディアンは上位バイトから下位バイトに向かって配置されます。インターネッツの世界はこれです。イメージ:
memory[offset + 0] = object[0]
memory[offset + 1] = object[1]
memory[offset + 2] = object[2]
リトルエンディアンは下位バイトから上位バイトに向かって配置されます。一般的に普及している CPU はリトルエンディアンです。イメージ:
memory[offset + 0] = object[2]
memory[offset + 1] = object[1]
memory[offset + 2] = object[0]
C 言語はエンディアンの違いを隠蔽してくれるという意味では高級言語と言えるかもしれません。そんな感じでエンディアンの対策をしていないと、エンディアンが異なる環境間でデータのやり取りができません。
私は常にリトルエンディアンの環境に合わせるように実装しました。ビッグエンディアンの環境ではバイト列を逆転させます。
サイズが異なる点
実は int やら float、double やらのサイズは C の規格で規定されてておらず、ABI (バイナリレベルのデータ順などを規定する既約)によって決定されます。
https://learn.microsoft.com/ja-jp/cpp/build/x64-software-conventions#scalar-types
整数型は stdint.h で定義されている uint32_t, int64_t 型等を使うことでサイズを保証できますが、浮動小数点型の場合そうはいきません!
この問題、ググっても ChatGP っても解決せず、1 ヶ月くらい食われました。最終的に boost ライブラリに boost::float**_t という型があり、これを参考にして実装しました。boost では float.h に定義されている浮動小数点型の精度のマクロを利用して float**_t 型を定義してるようです。
https://www.boost.org/doc/libs/1_74_0/boost/math/cstdfloat/cstdfloat_types.hpp
パディングによるサイズの違い
構造体のオブジェクトがメモリに配置される際、(空の詰め物)が入ることがあります。この詰め物のサイズも ABI に基づいてコンパイラが決めるので、環境によってオブジェクトのサイズが異なることがあります。
因みにパディングはメモリアクセスの高速化のために挿入されます。アライメント境界を超えてオブジェクトが配置されると、複数回に分けてメモリアクセスする必要があるため、アライメントを揃えるために詰め詰めします。
なのでこんなコードはアウト。
struct Token
{
    char type;
    /*  大抵ここにパディングが  */
    int value;
};

int main()
{
    Token tok;

    uint8_t buf[sizeof(Token)];
    std::memcpy(buf, &tok, sizeof(Token));  // オブジェクトをバイト列に変換

    send(buf);  // 送信
}
関係ないですが、キャストによってバイト列に再解釈すると、strict aliasing rules に違反しますので、未定義動作となる可能性があります。共用体を使うのも同様です。
例外的に char か char 修飾のポインタへのキャストは許されています。uint8_t にキャストする例をたまに見かけますが、uint8_t が unsigned char で typedef されているか定かではないのでギリアウトです。
int main()
{
    Token tok;

    uint8_t* buf = reinterpret_cast<uint8_t*>(&tok);
}
https://opaupafz2.hatenablog.com/entry/2024/03/31/120001
アライメント境界をいじることも出来ますが、コンパイラによって記述方法が異なったり、パフォーマンスが落ちるので、行儀がよろしくない気がします。ではどうするかというと、愚直にメンバ変数を一つずつ列挙しバイト列に詰めていきます。
しかし C++ には C# のリフレクションのようにメンバ変数を列挙するような仕組みがありません(嫌な予感)。C++ の伝家の宝刀、テンプレートメタメタプログラミングの出番です。
USCiLab/cereal では以下のように、構造体の内部に列挙用の関数を自分で定義することでメンバ変数を列挙しています。これを参考に実装しました。
struct MyRecord
{
    uint8_t x, y;
    float z;

    template <class Archive>
    void serialize( Archive & ar )
    {
        ar( x, y, z );
    }
};
こちらにメンバ変数を列挙する方法の記事を書きました。本稿より詳しく書いています。
力尽きました(’_’)